«Ya medimos.» Es la respuesta más habitual cuando preguntamos por indicadores al entrar en una planta. Y casi siempre llega con un dato pegado: el cumplimiento del plan preventivo, al 100 %.
Después preguntas de dónde sale ese 100 % y aparece un Excel que alguien rellena a final de mes, reconstruyendo lo que recopila de unos y de otros o lo que recuerda. Entre cierre y cierre no lo mira nadie. Cuando el número llega, ya solo describe un mes que terminó.
El 100 % no es mentira. Lo que pasa es que no dice lo que parece decir: dice que todas las órdenes se cerraron antes del corte, no que el mantenimiento se hiciera cuando tocaba.
Esa es la idea que ordena todo lo que viene después. Un indicador no mide tu planta: mide el registro que lo alimenta y el momento en que se hizo ese registro. Y eso no lo cambia la herramienta, es igual de cierto si el número lo calculas a mano que si lo saca un GMAO.
Un indicador solo sirve si cambia una decisión
Si el valor que salga no cambia nada de lo que ibas a hacer, ese indicador no es información: es trabajo administrativo con aspecto de gestión.
Suena obvio y casi nunca se aplica. Los cuadros de indicadores crecen por acumulación —una plantilla corporativa, el informe que pedía el jefe anterior, el panel que venía con algo— y no se depuran nunca, porque quitar un número parece admitir que se medía por gusto.
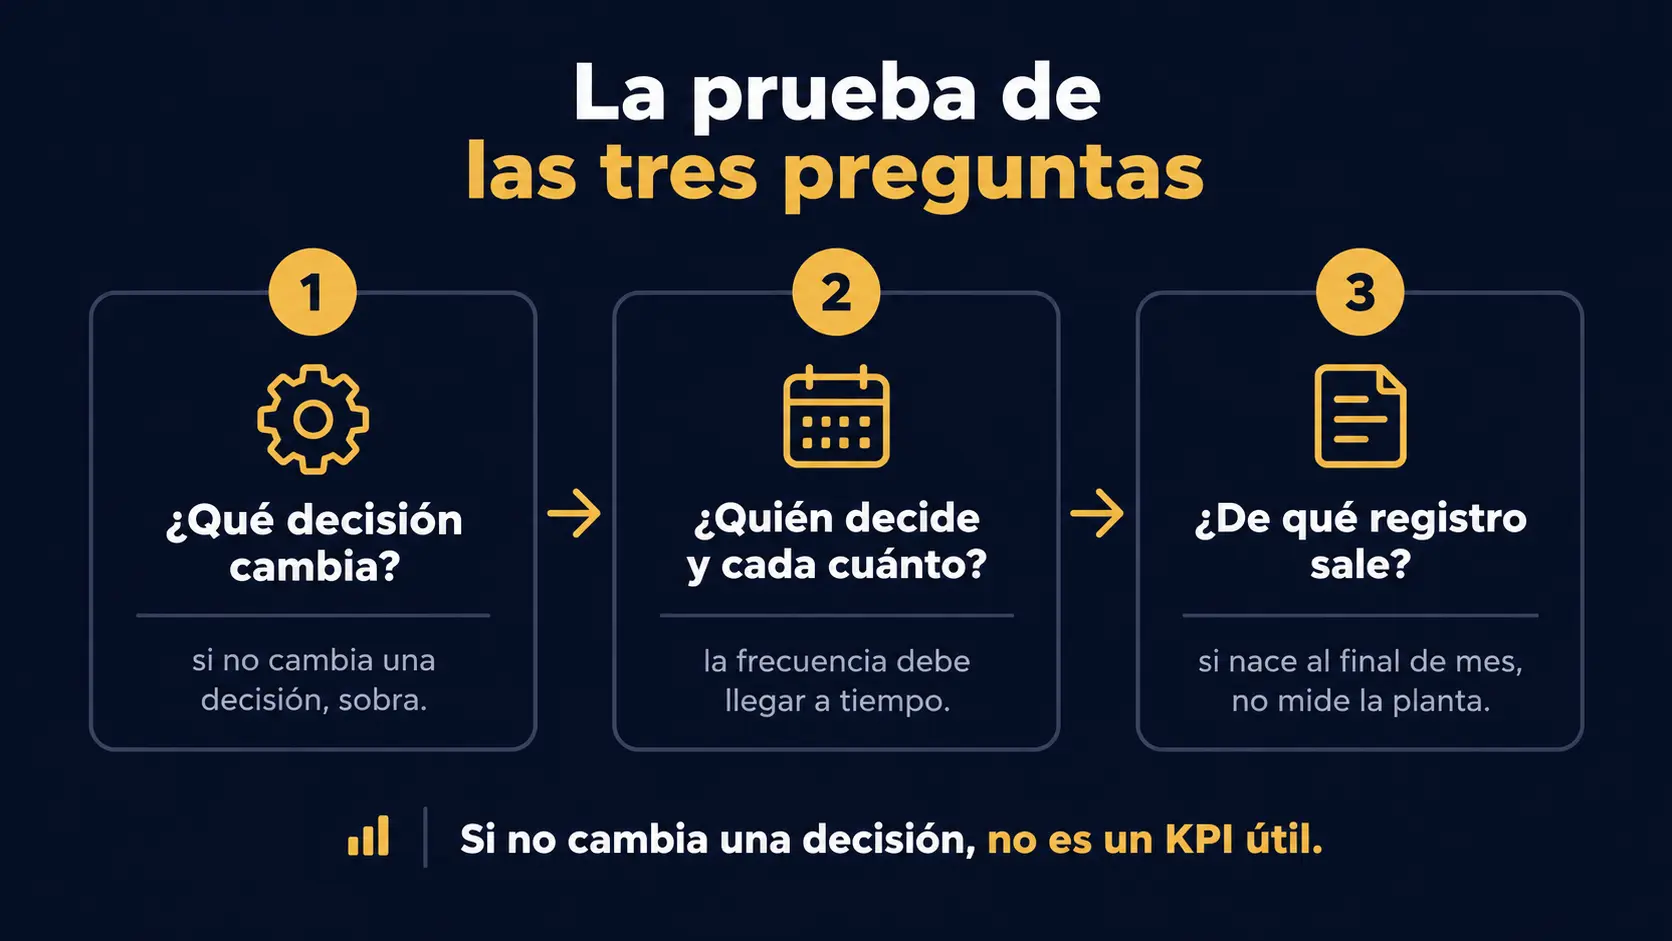
La prueba de las tres preguntas
Para cada indicador que hoy calculas, tres preguntas. En este orden.
- ¿Qué decisión tomo distinto según el valor que salga? Concreta: cambiar la frecuencia de un plan, adelantar una compra, parar una línea el sábado, pedir una persona más.
- ¿Quién toma esa decisión y cada cuánto? Si la decisión es semanal y el número es mensual, el número llega tarde por diseño.
- ¿De qué registro sale, y quién genera ese registro haciendo su trabajo? Si el registro lo produce alguien recopilando a final de mes, no estás midiendo la planta.
Un indicador que no contesta la primera se elimina. Uno que no contesta la segunda se cambia de frecuencia. Uno que no contesta la tercera es el peligroso: da un número puntual y creíble, y describe otra cosa.
Los que se miden por inercia
Los indicadores que se miden por inercia son fáciles de reconocer, y no por el indicador sino por lo que pasa alrededor. Nadie pregunta por él cuando falta. Nadie sabe decir qué valor sería bueno. Se calcula, se envía y no se discute en ninguna reunión.
Ahí el criterio es viejo y sigue funcionando: si el dato no sirve para tomar una decisión, no lo registres. Cada campo obligatorio que no alimenta ninguna decisión es tiempo que le quitas al técnico y una razón más para que rellene lo que sea con tal de cerrar.
Qué decisión permite cada indicador
Esta tabla no es un cuadro de mando recomendado. Es la lista de lo que se suele medir, con la decisión que cada uno permite tomar de verdad, el registro del que depende y el momento exacto en que deja de ser creíble.
| Indicador | Qué decisión permite | De qué registro depende | Cuándo deja de ser creíble |
|---|
| Cumplimiento del preventivo | Si el sistema se está usando de verdad, antes de mirar nada más | Fecha de ejecución de cada orden preventiva, no su fecha de cierre | Cuando las órdenes se cierran en bloque antes del corte de mes |
| MTBF | Si un activo se está degradando y toca revisar su plan | Cada avería registrada y el tiempo de funcionamiento del equipo | Cuando las paradas cortas no llegan al sistema, o el tiempo del denominador es de calendario |
| MTTR | Dónde se va el tiempo de una parada: en detectar, en esperar la pieza o en reparar | Hora real de aviso, de inicio, de fin y de puesta en servicio | Cuando esas horas se anotan de memoria días después |
| Disponibilidad | Qué líneas concentran la indisponibilidad y merecen atención antes que otras | Paradas, duración y motivo, sobre un tiempo de referencia acordado | Cuando no está escrito qué tiempo va en el denominador |
| Coste por activo | Si una máquina merece otro plan, otra pieza o su sustitución | Horas propias, repuestos y facturas de externos imputados al activo | Cuando solo entra en la cuenta lo que tiene factura |
| Backlog de mantenimiento | Si el equipo da abasto, o hay que priorizar, reforzar o subcontratar | Trabajo pendiente con su carga estimada, no el número de órdenes abiertas | Cuando el pendiente se depura cerrando órdenes viejas sin hacerlas |
| Reincidencias por activo | Si se está atacando la causa o solo el síntoma | Avería, causa y activo en cada correctivo cerrado | Cuando la causa se rellena con el primer valor del desplegable |
| OEE | Si el problema de una línea está en mantenimiento o está en el proceso | Disponibilidad, rendimiento y calidad medidos en la misma línea y el mismo periodo | Cuando el mantenimiento responde de un número que también mueven producción y calidad |
Si lo que buscabas era la lista corta, aquí está: en un departamento normal sobreviven a la prueba de las tres preguntas el cumplimiento del plan preventivo, la disponibilidad de los activos críticos, el coste por activo y las reincidencias en el correctivo. Cuatro. El MTTR y el MTBF entran cuando el registro ya es fiable, no antes, porque son los que más dependen de que las horas se anoten bien. Y el backlog cuando alguien tenga capacidad de decidir sobre él. Si hoy no mides nada, ni siquiera empieces por los cuatro: más abajo está por cuál.
Aquí no hay fórmulas a propósito: las fórmulas de MTTR, MTBF y disponibilidad ya están resueltas en otra página. Lo que no está resuelto es lo otro: de qué depende que ese cálculo signifique algo, y qué se mete exactamente en cada término.
Antes del indicador está el registro que lo alimenta
Ningún indicador de mantenimiento —cumplimiento, MTBF, MTTR, disponibilidad, coste por activo, backlog, reincidencias, OEE— se mide directamente. Seis salen enteros de lo mismo: de cómo se cierra una orden. Los otros dos dependen además de fuera del departamento —el coste, de compras; el OEE, de producción y de calidad—, pero la parte que te corresponde sigue entrando por el cierre. Cuándo se cierra, con qué tiempos y con cuánto detalle. Cambia el hábito de cierre y cambian los ocho números, sin que en planta haya ocurrido nada distinto.
Lo que vemos al entrar en plantas son dos roturas, y casi siempre juntas. La primera: el trabajo se hace el martes y la orden se cierra el viernes, con la hora aproximada. Cualquier indicador de tiempo queda inservible desde el origen, por bueno que sea el software. La segunda: la avería de diez minutos que se resuelve sobre la marcha no llega nunca al sistema. El histórico acaba conteniendo las averías grandes y perdiendo el goteo.
Y una hipótesis, nombrada como hipótesis porque no la hemos medido: buena parte de la indisponibilidad real de una línea son esas paradas cortas que nadie registra. No tenemos datos que lo demuestren. Sí tenemos lo que cuentan los turnos cuando se les pregunta uno por uno.
Cuándo un MTBF alto es mala noticia
El síntoma. El MTBF sube mes a mes y en planta nadie percibe que las máquinas fallen menos. Nadie celebra nada. El número mejora solo en el informe.
El modo de fallo. Las paradas cortas no se registran, así que el número de fallos del denominador baja mientras el tiempo del numerador no. También pasa por otro sitio: la norma es explícita en que ese tiempo es de operación, no de calendario. IEC 60050-192, entrada IEV 192-05-13, define el MTBF como mean operating time between failures. Si el denominador lleva horas de calendario, el indicador está inflado por construcción. Y aplica solo a elementos reparables: para los que no lo son, el término normalizado es MTTF. Un detalle más, por si alguien lo usa para dimensionar repuestos: que el MTBF sea el inverso de la tasa de fallo solo se cumple bajo distribución exponencial, no siempre.
Cómo lo detectas. Coge tres activos que en planta se tocan cada semana y mira cuántos correctivos tienen registrados en los últimos seis meses. Si alguno sale con cero, ya tienes la respuesta. Después comprueba, en el propio cálculo, si el tiempo que va al denominador es de funcionamiento o de calendario.
Qué se corrige. Una vía de registro de la parada corta que se resuelva en menos de un minuto y desde donde está el técnico. Y una decisión escrita, de una línea, sobre qué se considera avería registrable, para que dos personas del mismo turno respondan igual.
El cumplimiento al 100 % que nadie se cree
El síntoma. El cumplimiento sale al 100 %, o al 98 % sostenido, y dentro del departamento nadie se lo cree del todo. Es el indicador que más nos piden al llegar a una planta y, tal como se usa, el que menos sirve.
El modo de fallo. La fecha de cierre no es la fecha de ejecución, y el indicador se calcula con la primera. Si las órdenes se cierran en bloque antes del corte, el número describe la costumbre administrativa del departamento. A eso se suma una ambigüedad que rara vez encontramos resuelta por escrito: una orden mensual ejecutada con doce días de retraso, ¿cuenta como cumplida? Sin regla declarada, la respuesta la pone quien cierra, y cambia según el mes y según la persona.
El cumplimiento del preventivo no tiene una definición universal única. EN 15341 es un catálogo de indicadores de rendimiento del mantenimiento, pero su alcance publicado no menciona el cumplimiento de la planificación, y el texto completo es de pago y no lo hemos consultado: no podemos decirte si recoge un indicador de este tipo. Existe además una formalización sectorial de la SMRP, una asociación profesional, también de pago y también sin consultar. Lo que sí se puede afirmar es que no existe una regla normalizada que determine qué debe considerarse «preventivo cumplido». Por ejemplo, una orden ejecutada doce días tarde puede contabilizarse de forma distinta según la regla adoptada por cada organización. Por eso, más importante que copiar un porcentaje es declarar la ventana de tolerancia y mantenerla constante.
Hay una forma más rápida de que el número se caiga, y la hemos visto. En una auditoría de mantenimiento, en una planta industrial mediana con equipo propio, pedimos el parte de una tarea concreta que figuraba como cumplida. No existía. O, al menos, no lo encontraba nadie. Seguimos preguntando por otras tareas marcadas como cumplidas y volvió a pasar. No lo cuantificamos —no era una medición, era una auditoría—, así que no vamos a ponerle un porcentaje. Lo que se puede contar es que bastó una pregunta para abrirlo.
Cómo lo detectas. Tres comprobaciones, ninguna llega a la media hora. Compara, en una muestra de veinte órdenes, la fecha de ejecución con la fecha de cierre. Pinta la distribución de cierres por día del mes: si se apilan en los tres últimos días, el indicador ya te ha contado lo que mide. Y la más rápida de las tres: coge una tarea marcada como cumplida el mes pasado y pide su parte. Si no aparece, no hace falta seguir mirando.
Qué se corrige. Registrar la fecha de ejecución como campo distinto de la fecha de cierre. Declarar la ventana de tolerancia por escrito. Y mirar el número cada semana dentro del departamento, no una vez al mes y hacia arriba: un indicador que solo se mira en el informe mensual no corrige nada, porque cuando se mira ya no se puede hacer nada con él.
Un coste por activo que solo incluye lo que se compró
El síntoma. Sale el coste anual de una máquina y la cifra parece razonable, incluso baja. A nadie del equipo le cuadra con el tiempo que esa máquina les come.
El modo de fallo. Solo entra en la cuenta lo que tiene factura. En una empresa industrial pequeña con el mantenimiento externalizado, lo vimos en su forma más pura: el registro era un Excel con dos campos, máquina y avería, y el coste llegaba en un albarán a final de mes con el repuesto y las horas del mantenedor. El coste no vivía en ningún sistema, vivía en un papel suelto. Cuando el albarán se perdía, se perdía el único registro de lo que había costado esa intervención. La frase que resume el problema salió en esa reunión: «Ostia, ¿cuánto era ese albarán?». Y contestar «¿cuánto llevamos gastados este año en esta máquina?» era, en la práctica, imposible.
Cómo lo detectas. Pide las tres máquinas que más ruido dan en el día a día y mira si están entre las tres primeras por coste registrado. Si no lo están, sospecha del registro antes que de la máquina. Comprueba también si hay horas propias imputadas o solo compras.
Qué se corrige. Que cada intervención quede imputada a un activo concreto, con sus horas, de modo que el historial y el coste de cada equipo se construyan solos con el cierre y no con una recopilación posterior. Y decidir por escrito qué conceptos entran: horas propias, horas de externo, repuestos de almacén, consumibles. Un coste por activo comparable exige que la lista de conceptos sea la misma para todos los activos.
Con qué te comparas: el benchmark que no existe
No hemos localizado ningún benchmark de indicadores de mantenimiento con fuente primaria y metodología publicada: ni muestra, ni sector, ni periodo, ni definición de qué se midió. Circulan cifras en abundancia. Lo que no aparece es de dónde salieron. Conviene precisar el alcance de esa afirmación: la SMRP publica definiciones de métricas y valores de referencia en un documento de pago que no hemos consultado, así que no hablamos de él. Lo que no hemos encontrado es un benchmark con muestra, sector, periodo y definiciones publicados en abierto.
Y aunque apareciera, quedaría el problema de fondo: dos plantas que dicen medir lo mismo casi nunca miden lo mismo. Lo advierte la propia norma de indicadores. El alcance de EN 15341 sitúa sus KPI «in the framework of the external and internal influencing factors» —en el marco de los factores de influencia externos e internos—, que es una forma técnica de decir que un indicador no se interpreta sin las condiciones en que se midió. Un aviso, por si tienes una tabla de indicadores heredada: la versión UNE-EN 15341:2008 está anulada desde el 7 de octubre de 2020. Si tu tabla la cita, cita una norma retirada.
Tu MTTR y el suyo no miden lo mismo
La definición normalizada de MTTR es mean time to restoration, tiempo medio hasta la restitución del servicio: IEC 60050-192, entrada IEV 192-07-23. Incluye detección, diagnóstico, espera y verificación. Es decir, incluye las cuatro horas que el técnico estuvo esperando una junta.
El tiempo de reparación en sentido estricto tiene término y sigla propios, y no son MTTR: es mean repair time, MRT, recogido tanto en el vocabulario de la IEC como en la norma EN 13306.
Y hay que decir lo otro: mucha gente que dice MTTR está diciendo tiempo de reparación, llave en mano, y no está cometiendo ninguna excentricidad. La profesión lleva décadas partida en dos sobre esto. Selvik y Ford (2017) lo describen así: «The change of the meaning of MTTR in 1999 has the engineering population still divided between those using the present time definition, "mean time to restoration" and those keeping with the old definition» —la población de ingeniería sigue dividida entre quienes usan la definición actual y quienes conservan la antigua—. La fuente documenta la división; no dice cuál de los dos usos pesa más, y nosotros tampoco lo sabemos.
Así que no es una errata que se arrastra: es un desacuerdo que no se va a resolver en tu departamento. Lo que sí puedes hacer, y cuesta una línea: escribir qué entra y qué no entra en tu MTTR, y que esa línea viaje pegada al número. Sin eso, comparar tu MTTR con el de otra planta produce un número, no una comparación.
La disponibilidad admite tres denominadores distintos
EN 13306 no define la disponibilidad como una fórmula. La define como una capacidad: cualitativa, sin operación aritmética ninguna.
La fórmula aparece más adelante y con otro nombre —time based availability—, y con tres métodos que se diferencian en el denominador: tiempo en marcha sobre tiempo en marcha más tiempo de parada; tiempo de operación requerido sobre ese mismo tiempo más el tiempo de reparación; y tiempo de operación requerido sobre ese tiempo más el tiempo de parada. Tres denominadores legítimos, tres números distintos, la misma máquina y el mismo mes.
Y ahora la parte que provoca discusiones en los comités. La nota 1 del apartado 4.7 aclara que la falta de recursos externos no afecta a la disponibilidad del ítem, «although the item may not be available from the user's viewpoint». Traducido a planta: una máquina parada porque no ha llegado el material sigue estando disponible según la norma, mientras producción la ha visto parada toda la mañana. Las dos lecturas son defendibles y las dos personas tienen razón. Por eso el acuerdo hay que cerrarlo antes de enseñar el número, no durante.
Y el vocabulario de la IEC añade una distinción que conviene tener a mano en cualquier negociación con un proveedor: la disponibilidad intrínseca, la que da el diseño en condiciones ideales, no es la operacional, la que sale con tu logística y tu organización dentro. Cuando un proveedor te enseña la disponibilidad de su máquina, normalmente te está enseñando la primera.
El 85 % de OEE tiene autor, pero no tiene estudio
El 85 % de OEE que se presenta como «clase mundial» tiene un origen perfectamente localizable: Nakajima, Introduction to Total Productive Maintenance (Productivity Press, 1988). Es un libro, no una norma, y no tiene URL que enlazar. Describía el nivel que se observaba en las plantas premiadas por el JIPM.
Eso es exactamente lo que es: un valor observado en un conjunto de plantas concretas hace casi cuarenta años. No es una media del sector, no aparece en ninguna norma y no hemos localizado ningún estudio que lo valide como umbral general.
Que se haya copiado durante casi cuarenta años se entiende sin esfuerzo. Es un número redondo, tiene detrás a una autoridad real del TPM y ofrece una referencia donde no había ninguna. Cualquiera lo habría repetido.
Lo que delata la cadena de copias es el desglose. Raju y otros (2022) recogen en su tabla 1 un factor de calidad superior al 99,9 %; otras versiones en circulación dan 99 %. La diferencia es lo bastante pequeña como para desaparecer al redondear el objetivo final, y por eso ha sobrevivido casi cuarenta años sin que nadie tropezara con ella. Si vas a heredar un objetivo, al menos que sea uno cuyos componentes coincidan entre las fuentes que lo citan.
Y no creas que esto pasa solo con las cifras de foro. Ocurre igual con números que publican organismos oficiales: basta con seguir el rastro hasta el estudio para encontrar, muchas veces, que la fuente se cita a sí misma y no publica ni la muestra ni el método. Que una cifra la firme una institución solvente no dice nada de dónde salió.
Con qué empezar si todavía no mides nada
Si todavía no mides nada, empieza por el cumplimiento del plan preventivo, y solo por ese, durante unos meses.
La razón no es que sea el más informativo. Es que es el único que depende solo de tu organización. El MTBF depende de cómo se comporten las máquinas. El coste depende de compras y de proveedores. La disponibilidad depende de con quién acuerdes el denominador. El cumplimiento depende de vosotros, y se puede corregir la semana que viene sin pedirle permiso a nadie.
El cumplimiento del preventivo es, a la vez, el más fácil de falsear. Las dos cosas son ciertas y no se contradicen. La diferencia entre un cumplimiento que informa y uno que engaña no está en el indicador: está en cuándo se cierra la orden.
Por eso funciona solo con tres condiciones, y si falta una, mejor no empezar:
- que el plan preventivo esté escrito con frecuencias que alguien defienda, no heredadas del manual del fabricante sin revisar;
- que la ventana de tolerancia esté declarada por escrito y no cambie de un mes a otro;
- que la fecha de ejecución se registre aparte de la fecha de cierre.
Sin las tres, el número que salga describirá el calendario administrativo del departamento. Con las tres, en dos meses tienes un termómetro honesto de si el sistema se está usando de verdad, que es lo que hay que saber antes de mirar nada más.
Aquí es donde entra la herramienta, y conviene decir qué parte resuelve y cuál no. De las tres condiciones, el software se hace cargo de una: en Okron el denominador y la ventana de tolerancia del cumplimiento se configuran, así que la regla de tolerancia queda escrita en el sistema y no en la cabeza de quien cierra. Los indicadores salen de los cierres de las órdenes, y cada uno se puede mirar mes a mes, que es la única comparación que se sostiene sin benchmark externo.
La primera condición, que el plan tenga frecuencias que alguien defienda, es trabajo previo y no la hace ningún software. Y la tercera es la que decide todo: si la orden se cierra el viernes, el número seguirá describiendo el viernes. Acercar el registro al momento del trabajo es una decisión del departamento y un hábito que hay que sostener. El software puede ponerlo a mano; tomar la decisión, no.
Qué llevar a dirección y qué dejar en el departamento
A dirección va poco, siempre lo mismo y siempre con las condiciones de medida al lado. Tres cosas bastan: el coste de mantenimiento de los activos críticos, la indisponibilidad no planificada de las líneas que de verdad importan, y una frase que diga qué incluye cada uno de esos dos números.
En el departamento se queda el resto, que es donde sirve: MTTR desglosado para ver si el tiempo se va en detectar, en esperar la pieza o en reparar; reincidencias por activo; backlog; cumplimiento semanal. Son indicadores de trabajo, no KPI de mantenimiento para presentar. Suben mal: en cuanto se presentan, se empiezan a cuidar.
La regla que ahorra reuniones enteras es la de la definición adjunta. Un indicador que sube sin decir qué incluye acaba discutido en lugar de usado, y la discusión no la gana quien tiene razón, la gana quien habla más alto. Escribir esa definición cuesta media hora una sola vez.
Si tienes un cuadro de indicadores heredado que nadie mira, o si estás por empezar y no sabes por dónde, escríbenos y te lo enseñamos sobre tu propio plan preventivo: qué se está midiendo hoy, de qué registro sale cada número y cuál de ellos cambiaría una decisión la semana que viene.